معرفی پروژه عظیم داده آموزشی زبانهای هندی توسط NVIDIA و AI4Bharat
در پروژهای مشترک از NVIDIA، AI4Bharat و آزمایشگاه هوش مصنوعی IIT Madras، مجموعه دادهای عظیم برای پیشآموزش مدلهای زبان هندی با بیش از ۲.۸ تریلیون توکن در ۲۲ زبان رسمی هند به زودی منتشر خواهد شد. این مجموعه در کنار یک خط لوله تولید داده متنباز با شتابدهی GPU، نقش مهمی در توسعه فناوری زبان هندی ایفا خواهد کرد.
چرا این پروژه اهمیت دارد؟
فناوری زبان هندی همواره به دلیل کمبود داده آموزشی از زبان انگلیسی عقب مانده است. میتش خاپرا، رهبر AI4Bharat و از برگزیدگان لیست ۱۰۰ نفر برتر AI TIME در ۲۰۲۵، مشکل اساسی را «داده ناکافی برای زبانهای هندی» میداند. این پروژه با افزایش حجم داده و ارائه دستورالعمل باز برای تولید داده، زمینه را برای ساخت مدلهای توانمندتر در زبانهای هندی فراهم میکند.
پوشش گسترده: اسکریپت بومی و لاتین نویسی شده
این کورپوس شامل داده اسکریپت بومی برای همه ۲۲ زبان و داده لاتین نویسی شده (رومانیزه) برای دوازده زبان است. بدین ترتیب، ۳۴ ترکیب زبان-اسکریپت ایجاد شده و پشتیبانی از شیوههای نوشتاری مختلف مردم هند تضمین میشود. دادهها شامل متون ترجمه شده از منابع انگلیسیِ گزینش شده در حوزههایی مانند ریاضی، کد، پرسش و پاسخ و محتوای تخصصی است. هر رکورد قابلیت ردگیری تا سند اولیه را دارد و کیفیت خروجیها با معیارهای دقیق بررسی میشود.
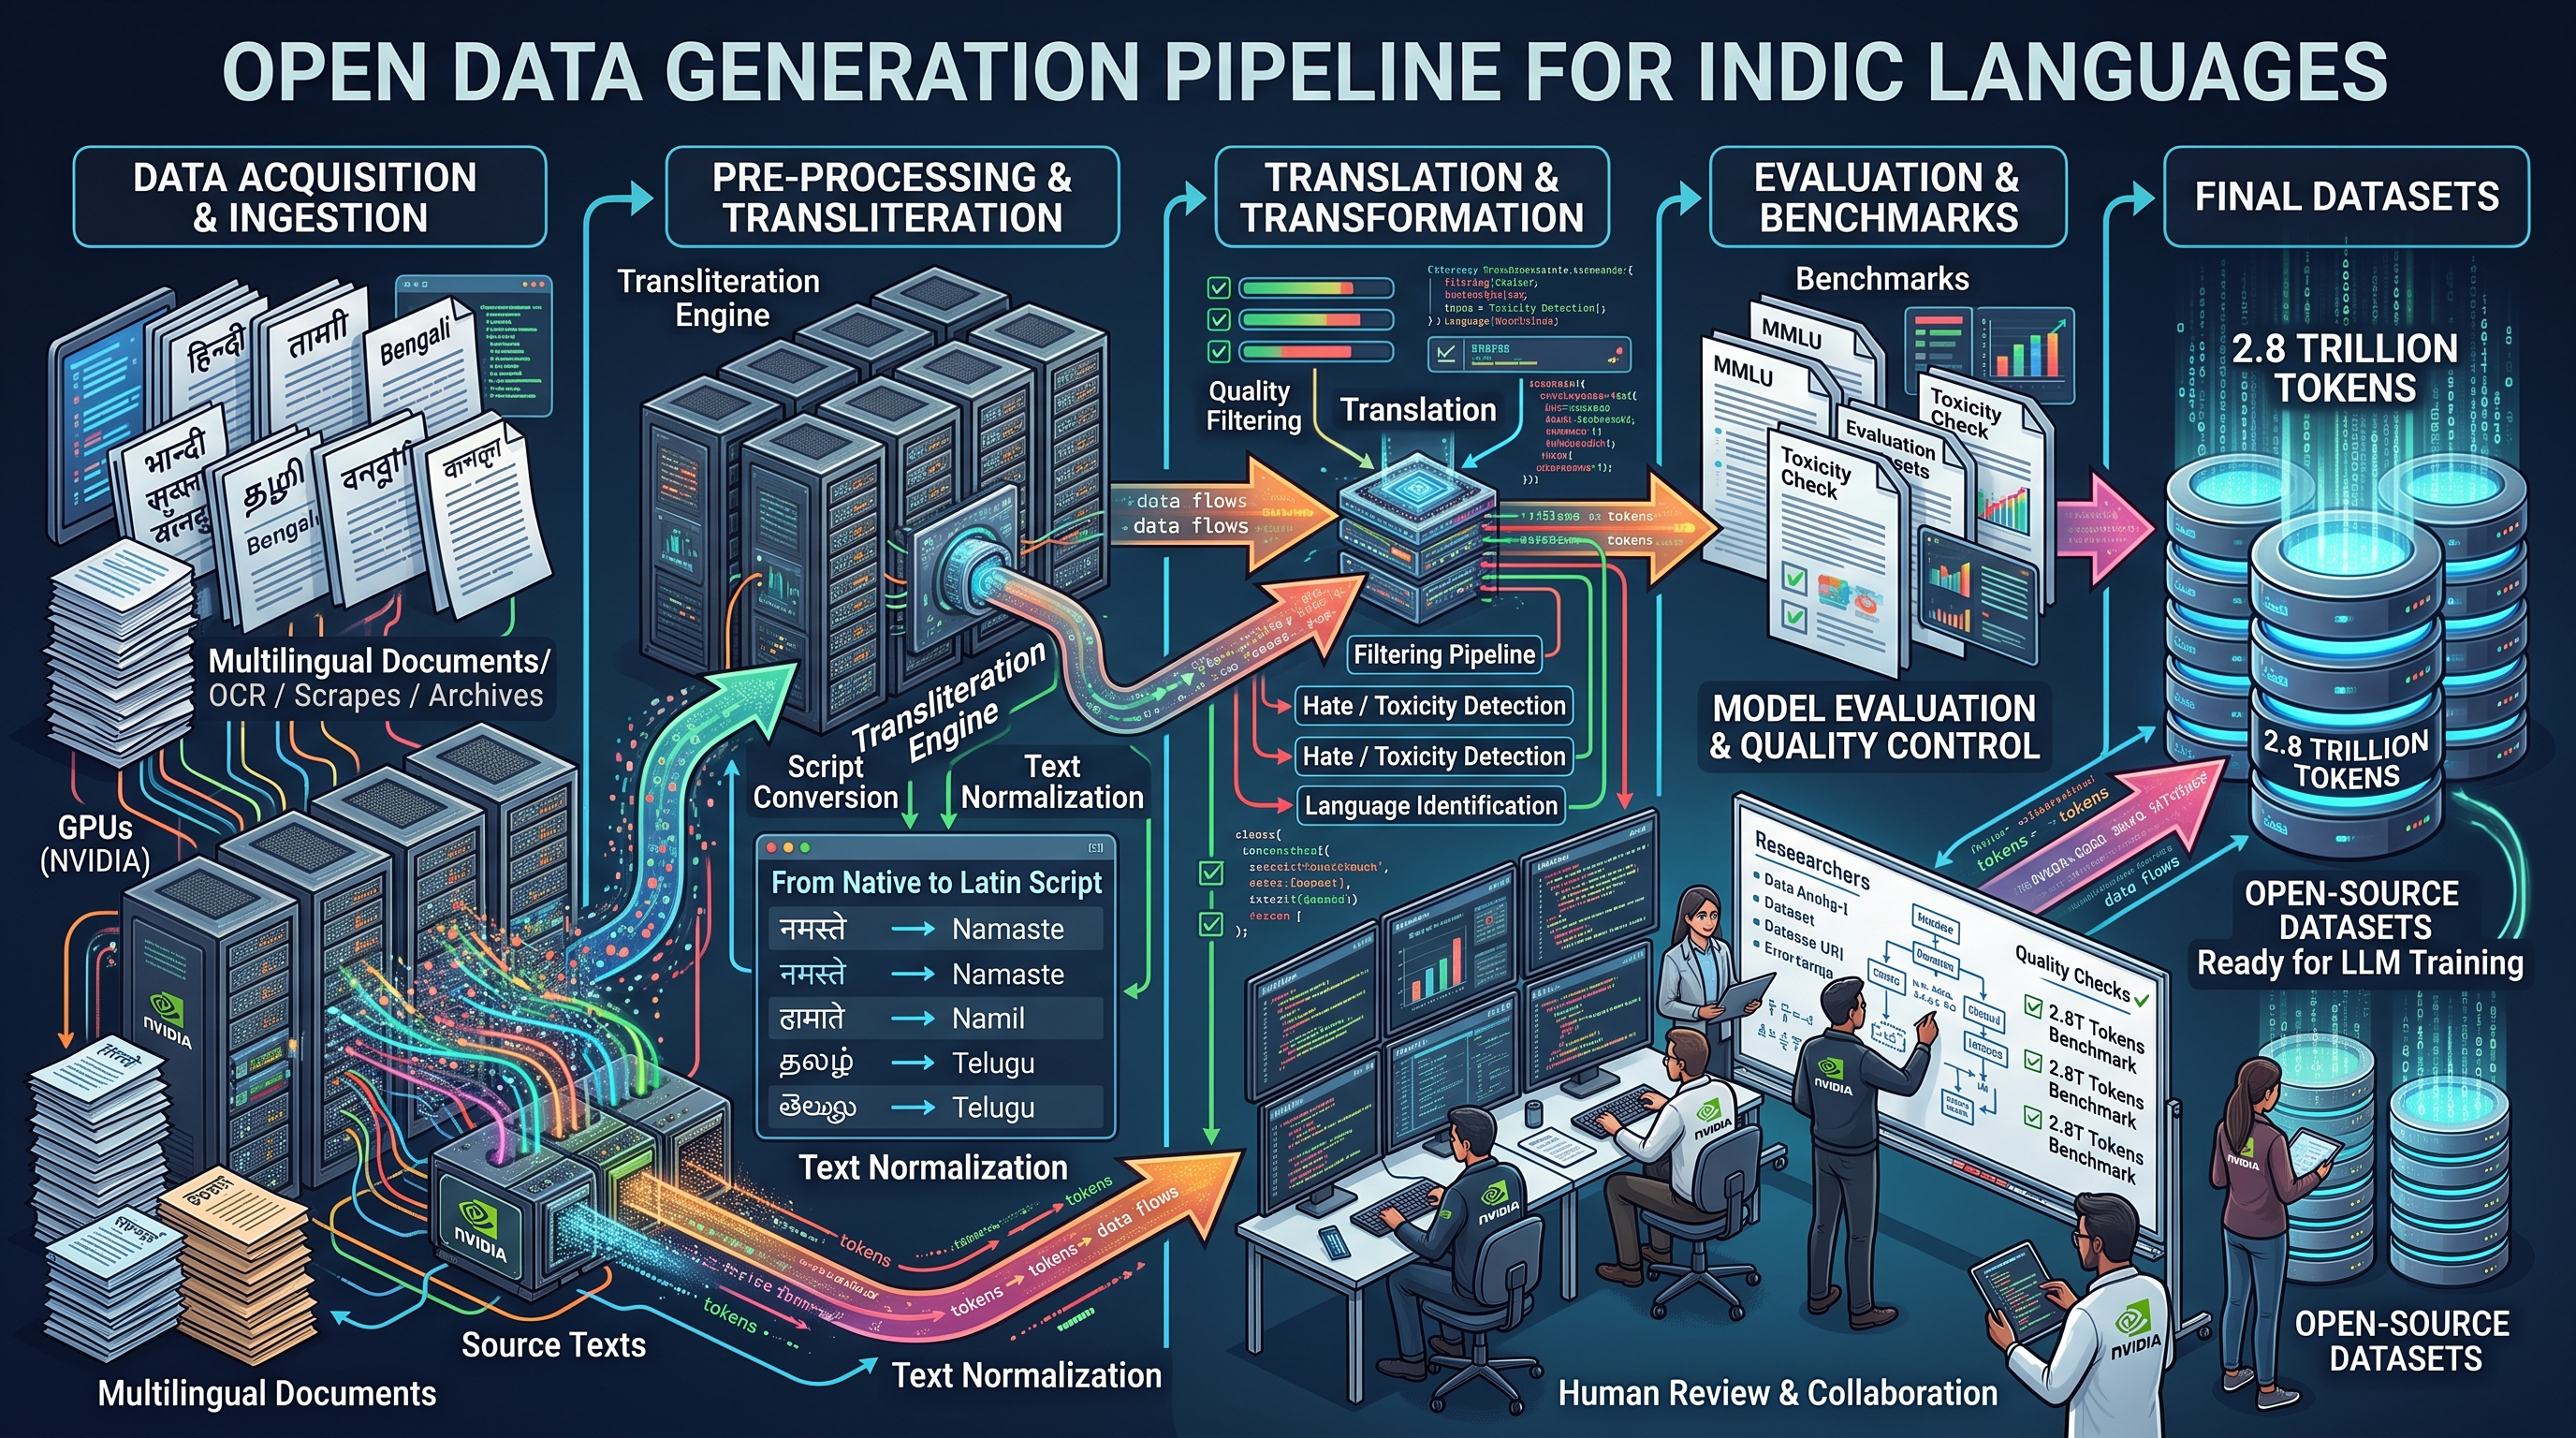
خط لوله تولید داده باز و منعطف
خط لوله ارائه شده به صورت متنباز و با شتابدهی GPU کار میکند و شامل دستورالعملها، جریانهای LLM و چکهای کیفیت است؛ توسعهدهندگان میتوانند فرآیند را با مواد اولیه خود سازگار و داده بیشتری تولید کنند. دادهها با حفظ معادلات، جداول و کد ترجمه و ارزیابی میشوند. همچنین، تبدیل به اسکریپت لاتین برای دوازده زبان به صورت دو مرحلهای و مبتنی بر بازخورد انجام شده تا خطاهای ترجمه به حداقل برسد.
افزایش قابلیت مدلهای هندی
پیشآموزش ادامهدار مدل Nemotron 3.5 Super VL نشان داده است که اضافه شدن ۱۰ میلیارد توکن هندی (از متنهای طبیعی و متن مصنوعی این کورپوس) باعث رشد چشمگیر امتیازات در پنج معیار دانش و استدلال هندی شده است. مدل نهایی بر پنج معیار ششگانه عملکردی و کیفیت زبان برتری داشته و در معیارهای IndiVibe از Sarvam AI نیز ارتقا یافته است.
گردشکار تخصصی برای زبانها
برای دوازده زبان، ترجمه و ارزیابی کیفیت به صورت اسناد کامل انجام شده و تنها خروجیهای با امتیاز بالای ۷۵ ثبت گردید. برای ده زبان دیگر، ترجمه با مدل Bodhan AI انجام و کیفیت با Gemma-4-31B-it ارزیابی شد. برخی زبانها مانند سانتالی و مانیپوری نیازمند فرآیندهای خاص بودند (پنجرهگذاری یا تبدیل چند اسکریپتی).
توصیهها و محدودیتها
تولید داده مصنوعی از منابع انگلیسی گرچه دسترسی را افزایش میدهد، اما جایگزین متون بومی هندی یا تضمینکننده دانش و فرهنگ محلی نیست. توصیه شده ترکیب این کورپوس با داده طبیعی هندی برای کاربردهای واقعی صورت گیرد. ارزیابی کیفیت غالباً خودکار و تکمیلشده با بازدید انسانی نمونهای بوده و نیاز به بازبینی گستردهتر برای برخی زبانها احساس میشود.
نحوه استفاده و آغاز کار
مجموعه داده با پیکربندی بر اساس زبان، اسکریپت و منطقه قابل بارگذاری است (مثلاً hi-Deva-IN برای هندی دیوناگری یا hi-Latn-IN برای هندی لاتین نویسی شده). امکان نمونهگیری قبل از آموزش، بررسی کارت داده و مجوز وجود دارد و استفاده از استریم در Hugging Face Datasets فراهم شده است.
نرمافزار NeMo Data Designer با پلاگین ترجمه Nemotron Bharat قابلیت تنظیم دستورالعملها، ارزیابی، بازنویسی، پنجرهبندی و تغییر اسکریپت را دارد؛ سیاست فیلترگذاری نیز در اختیار کاربر میباشد.
منابع و اطلاعات بیشتر
گزارشهای ضمیمه درباره دادههای مصنوعی و فنی، جزئیات تولید و ارزیابی را ارائه میدهند. برای معیارهای ارزیابی، وبلاگ AI4Bharat و NVIDIA با عنوان "Better Models Need Better Benchmarks: Introducing Indic-LLM-Eval-Suite" قابل مطالعه است.
این همکاری از مدلها و ابزارهای Gemma (گوگل)، Indic Translate (Bodhan AI) و NeMo Data Designer (NVIDIA) بهره برده و مجموعه Nemotron Pre-Training Datasets نیز پایگاه دادهای اضافی فراهم میکند.